- 네이버 보안 백서를 분석해 취약점 탐색 목표를 XSS와 로직 버그 탐지로 설정.
- Discovery, Hunt, Report 세 단계로 나눈 Codex 에이전트와 보조 도구를 제작.
- 약 3주 동안 10개 이상의 취약점을 찾았고, 세부 내용은 수정 이후에 공개.
이 블로그에 올린 모든 기술적 분석과 취약점 사례는 승인된 대상에 윤리적 가이드라인을 지키며 수행한 결과입니다. 모든 테스트는 해당 프로젝트의 공식 스코프와 정책 범위 안에서만 안전하게 진행했습니다. 이 글은 교육과 보안 연구를 목적으로만 작성했으며, 악용하거나 모방해서 생기는 법적 책임은 행위자 본인에게 있습니다.
@ElleuchX1과 함께 이야기를 나눌 수 있어서 좋은 경험이었습니다.
3월
프로젝트의 목표를 “AI 기반 자동 취약점 탐지 및 버그바운티 보조 시스템”으로 설정했습니다.
그다음 네이버 버그바운티에 대한 사전 정보를 찾아보며 프로젝트의 구체적인 목표를 정했습니다.
버그바운티란?
버그바운티는 기업이 보안 취약점을 제보받기 위해 화이트 해커에게 서비스에 대한 해킹을 합법적으로 허용하고, 발견한 취약점의 심각도에 따라 보상을 지급하는 제도입니다.
네이버 버그바운티
네이버는 자사 서비스의 취약점을 일찍 발견해 이용자에게 안전한 서비스를 제공하려고 2015년부터 버그바운티 프로그램을 운영하고 있습니다.
블로그, 카페, 페이, 쇼핑 등 네이버가 운영하는 앱과 웹 서비스, 그리고 웨일 브라우저와 클로바 디바이스 같은 IoT 기기가 버그바운티 대상입니다.
버그바운티를 시작하기 전에 네이버 버그바운티의 공개 문서를 바탕으로 대상에 대한 정보를 모았습니다.
네이버는 2022년부터 한 해의 보안 활동을 담은 네이버 보안 백서(NAVER Security Whitepaper)를 발간합니다.
이 문서에는 버그바운티 참가자 수, 지급한 리워드, 총 제보 건수, 조치 기간 같은 기본 정보가 있습니다. 외부와 내부에서 제보된 주요 보안 버그 유형과 제보가 많았던 서비스도 알 수 있습니다.
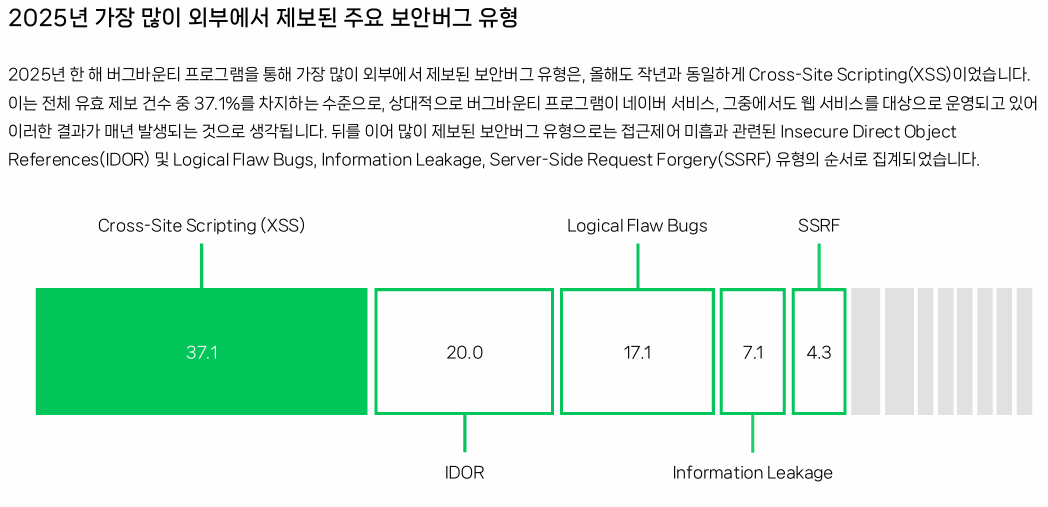
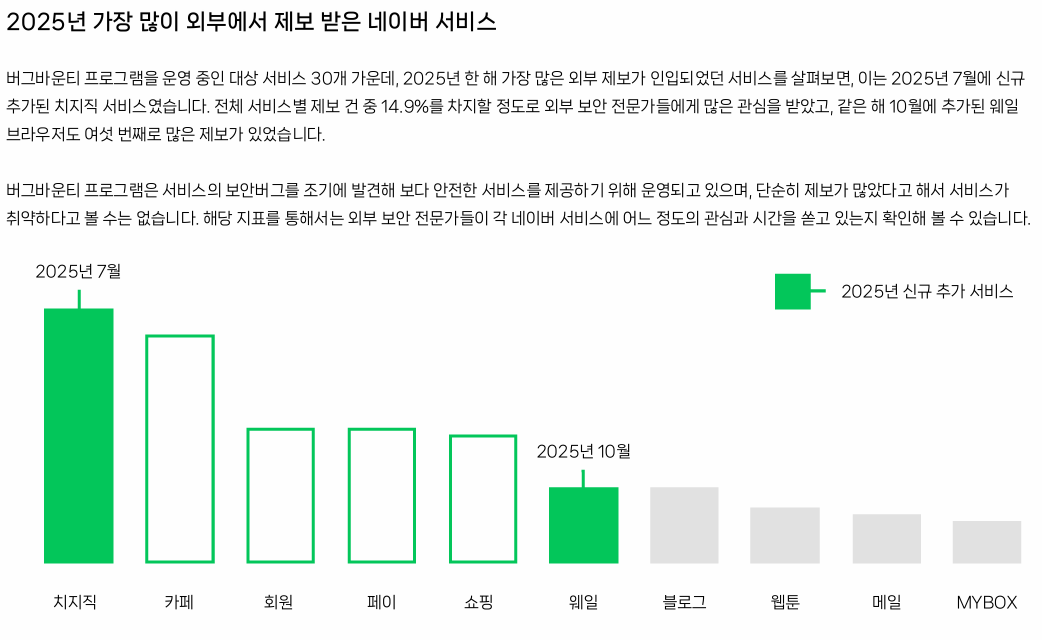
2022년부터 2025년까지의 보안 백서를 ChatGPT로 분석했습니다. 제보된 주요 보안 버그 유형 중 XSS가 꾸준히 1위였고, IDOR와 Logical Flaw 같은 취약점도 많았습니다. 카페, 블로그, 페이, 쇼핑, 회원처럼 사용자 상호작용이 많은 서비스에서 제보가 많았습니다.
이 조사를 바탕으로 프로젝트 목표를 “네이버 버그바운티의 웹 서비스 대상”에서 **“XSS와 Logical Bug 탐지”**로 좁혔습니다.
4월
공개된 Agent 설계 방법론 자료를 참고해 워크플로우를 설계했습니다.
Agent 워크플로우 설계
아래 자료를 참고했습니다.
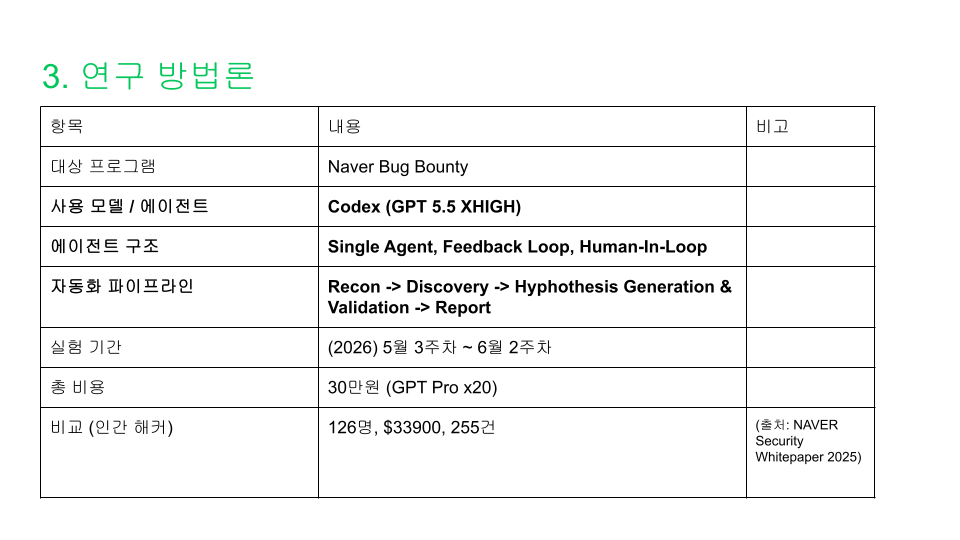
비용 문제 때문에 토큰 한도가 작은 Claude Code 대신 한도가 큰 ChatGPT Pro x20을 구매해 Codex 5.5 XHIGH로 진행했습니다.
Cloudflare가 공유한 Vulnerability discovery harness를 조금 바꿔서 전체 구조를 설계했습니다.
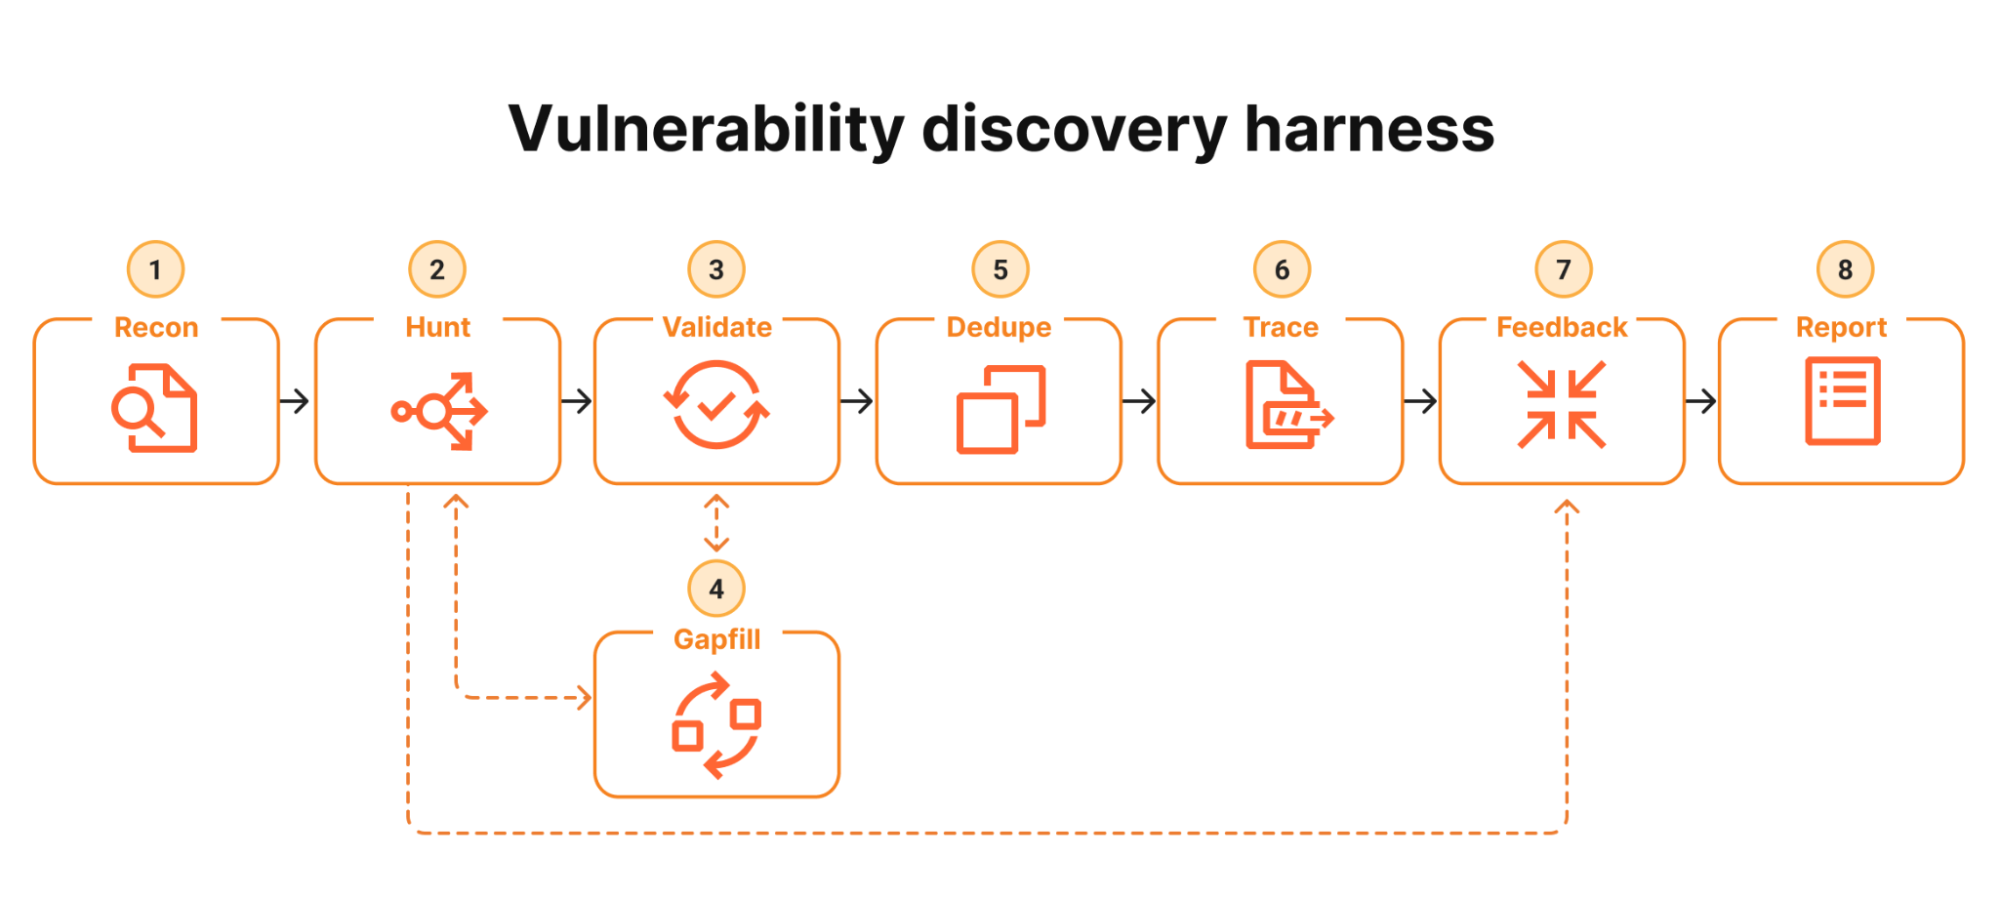
Codex로 Claude Code만큼의 Multi-Agent 구조를 짜기는 어려웠습니다. 하나의 Main-Agent가 움직이면 서비스 하나의 맥락을 더 잘 이해할 것 같아서, Multi-Agent를 중심에 두지 않고 Phase라는 개념으로 구현했습니다. 공식 용어인지는 모르겠습니다.
Discovery, Hunt, Report 세 단계로 나누고, 시스템 프롬프트에 단계 사이의 전환 조건과 전환할 때의 행동을 적었습니다. 예를 들면 이전 단계의 내용을 파일에 기록한 뒤 다음 단계로 넘어가는 식입니다.
- Discovery: static recon, dynamic discovery
- Hunt: Hypothesis Generation & Validation, Impact
- Report: write report draft
다만 Context Window가 가득 차서 Compact되거나 이전 내용을 잊어버리는 문제가 있었습니다. 아래 방법으로 문제를 줄였습니다.
- JS 파일을 분석하는 Sub-Agent 사용 (Codex 5.3 Spark XHIGH)
- 한 session에 타겟 하나만 프롬프팅 (예: cafe.naver.com, blog.naver.com을 각각 따로 실행)
시스템 설계
정확한 용어인지는 모르겠지만, Agent에게 줄 주변 도구를 기획하고 구현했습니다.
Agent라는 말의 뜻을 살려, 실제 윤리적 해커가 Pentesting과 Bug Bounty에 쓰는 도구를 AI가 쓰기 쉽게 만들었습니다. MCP는 쓰지 않았습니다.
Service Note
타겟 서비스(hostname으로 구분)의 정보를 담는 노트입니다.
blog.naver.com/
    index.md
    path1.md
    path1/path3.md
파일로 저장하고, markdown 파일에 각 엔드포인트의 메서드, 파라미터, 기능을 정리했습니다.
HTTP Proxy
Burp Suite의 Proxy처럼 HTTP 요청을 기록하고 확인합니다. 같은 요청을 반복하지 않도록 만들었고, 핵심은 HTTP-ID라는 개념으로 hallucination을 막은 것입니다.
모든 (Req, Res) 쌍에 고유한 HTTP-ID를 부여했습니다.
Proxy 기능은 다음과 같습니다.
- Response Header에
X-HTTP-ID: ...를 넣어서 반환 - host, path,
HTTP-ID등으로 검색해 Req, Res 반환 - Static(image, video)은 저장하지 않음
brutecat의 연구에도 비슷한 개념이 쓰인 것을 프로젝트가 끝나고 알았습니다.
5월
남은 부분을 구현하고, 실제 네이버 버그바운티 대상에서 가동하며 방법론을 점검했습니다.
처음 가동했을 때는 사전 조사에서 확인한 blog.naver.com과 cafe.naver.com의 Client Side 취약점을 중점적으로 살폈습니다.
이후에는 버그바운티 대상 전체로 넓혀서 돌렸습니다.
성과는 글 맨 아래에 따로 적겠습니다.
방법론
- Legacy Endpoint, Feature, Code
- JavaScript
- Frontend and Backend Validation Mismatch
- URL
Grepper
프로그램이 도는 동안 JS 파일을 분석하면서 리눅스 grep 명령어를 많이 쓰는 것을 봤습니다. 반복되는 작업을 AI에게 시키지 않고 코드로 해결했습니다.
구조는 다음과 같습니다.
Keywords/
    client/
        xss.json
        open_redirect.json
        ...
    server/
        idor.json
        ...
각 keyword 파일은 아래와 비슷하게 구성했습니다.
{
  "keywords": ["eval", "document.write"]
}
6월
프로젝트의 당위성을 경제적 측면에서 분석해 연구 목적과 필요성을 보강했습니다.
보고서를 쓰고 발표자료를 만들었습니다.
발표자료는 학교 내부 발표에 사용했습니다.
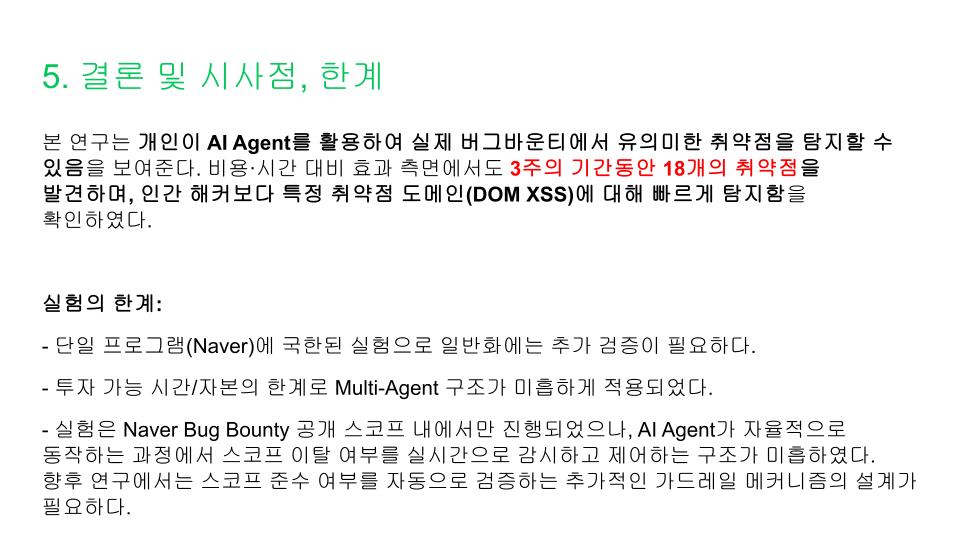
결과 및 성과 요약
| 항목 | 내용 |
|---|---|
| 개발 기간 | 약 3주 |
| 사용한 토큰 | 약 15B |
| 찾은 취약점 | 취약점 수정 후에 공개하겠습니다. |
| 제보 건수 | 39건 · 2026.05 – 2026.10 |
| 유효 | 24건 (61.5%) · 보상 책정 21건, 수정 중 3건 |
| 무효 | 15건 (38.5%) · 중복 6건 (15.4%), N/A 9건 (23.1%) |
| 오탐(FP) | 3건 (7.7%) |
- N/A는 ‘버그바운티 프로그램을 통해’ 또는 ‘내부적으로’ 이미 인지하고 있던 이슈입니다.
- 중복은 다른 제보자가 먼저 제보한 이슈입니다.